每次有新的AI模型发布,团队群里总会热闹一阵:分数又高了多少,哪个评测又登顶了,要不要赶紧换过去。
换过去之后呢?多数时候,业务没什么肉眼可见的变化,账单倒是有。有的活儿根本用不上那么强的本事,硬塞给最贵的那个去做,等于每天请一位专家来干分拣的活。专家当然干得好,就是贵,而且贵得毫无必要,也毫无道理。
这篇文章只讲一件事:选AI模型,早就不该按榜单选了。该按什么选?按你自己的任务,和你自己的账单。
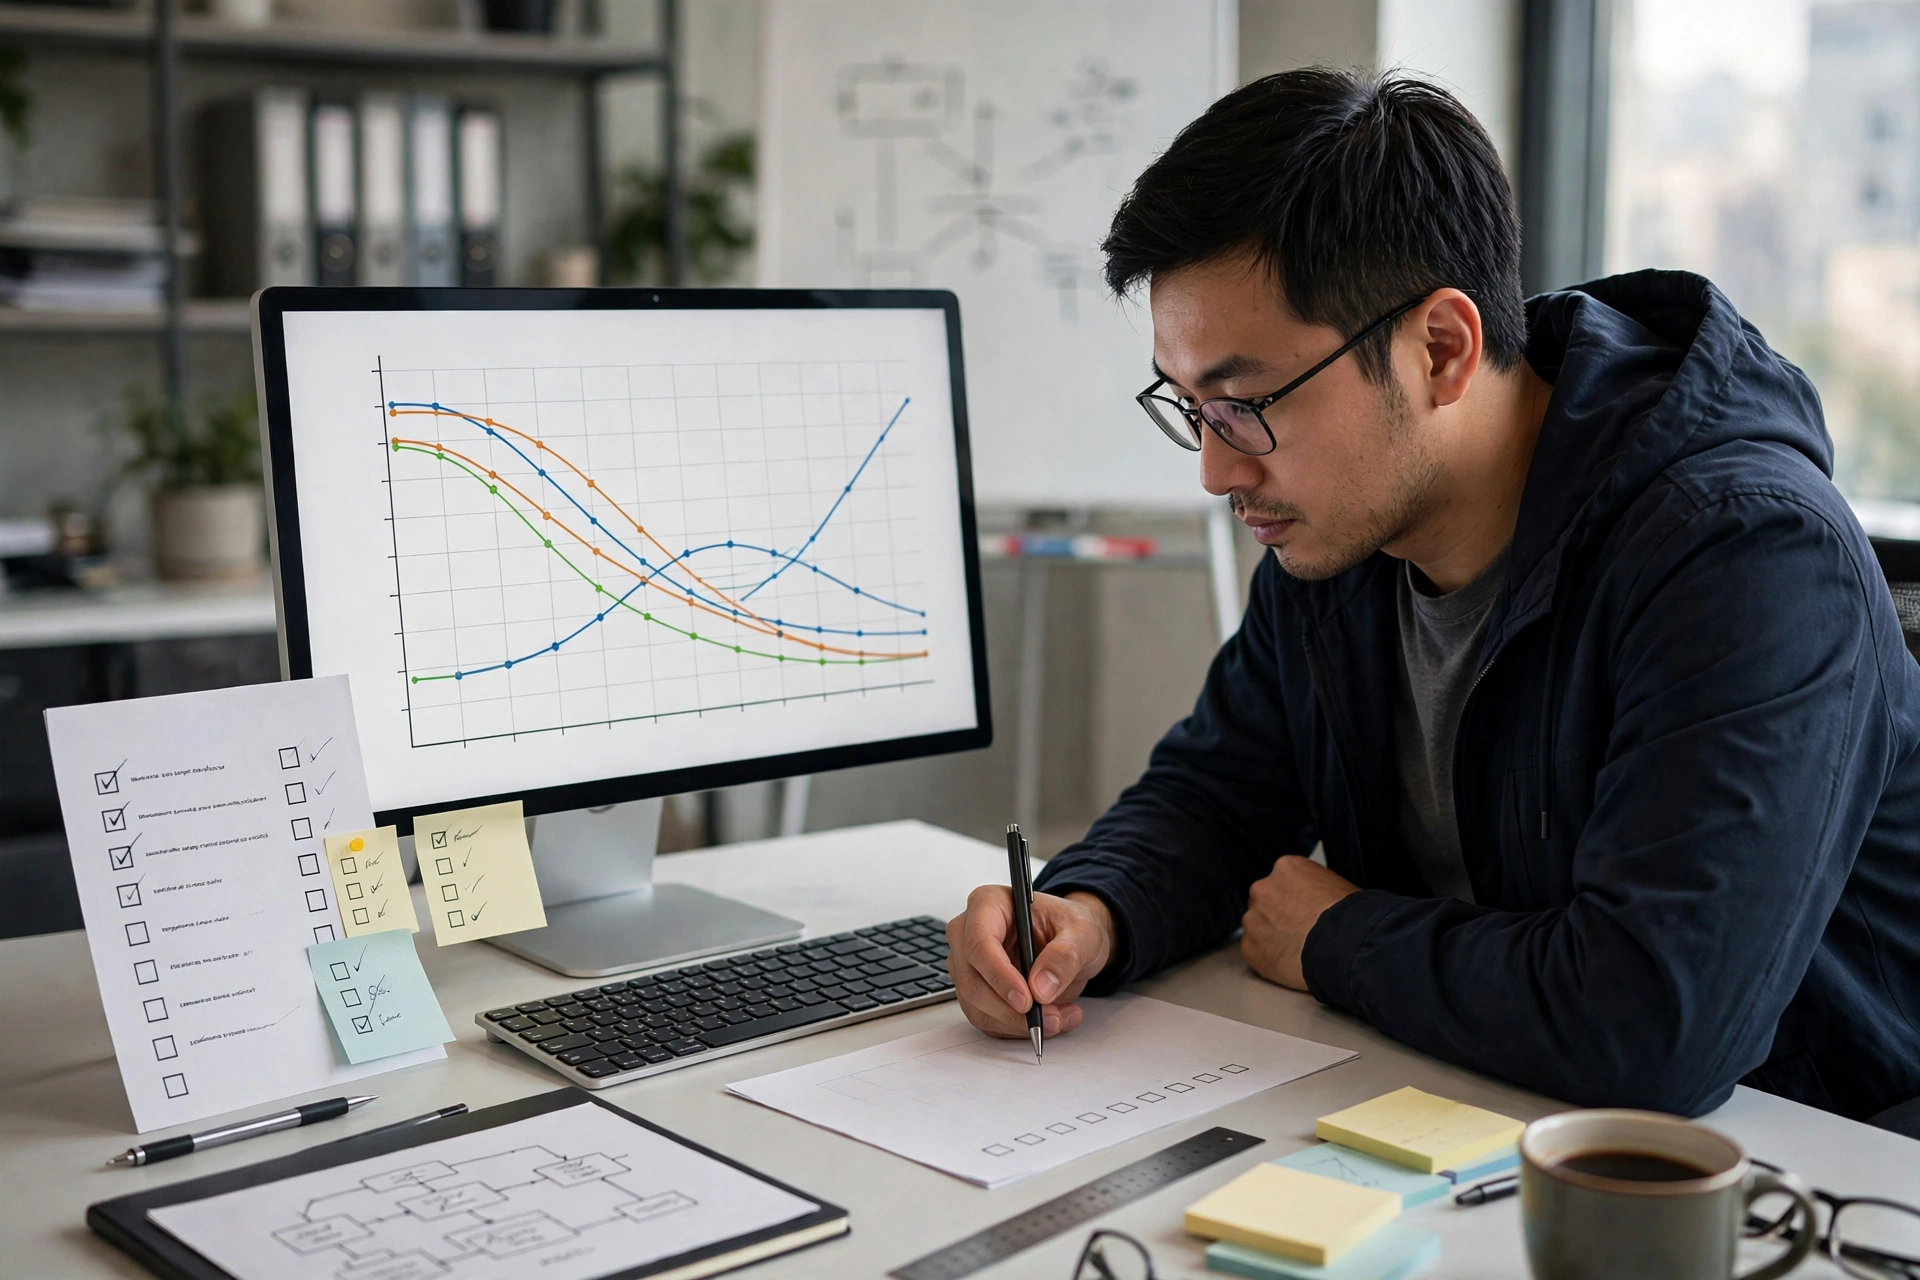
图:AI模型选型的第一张表,不该是榜单,而是成本账。
分数差的那几分,业务里根本看不见
先说个容易得罪人的判断:对绝大多数已经在跑的业务来说,头部几个选择之间的分数差距,在真实任务里是看不见的。
评测考的是难题、怪题、边界题,业务里跑的却是大量重复的、规矩的活:把一段话整理清楚,把一张表里的信息摘出来,把用户的问题按规矩答好。这类活,考七十分的能干,考九十分的也能干,用户坐在对面,分不出哪个是九十分。但价格分得出来,而且分得很开:单次调用的价差能拉到数倍,量一跑起来,月底的账单就是两个世界。
公开市场的风向其实已经变了。近期的行业报道里,一个很明确的信号是,新一轮竞争的重点正在从单纯比能力,转向比单位成本、比运行速度、比能不能稳定地把任务做完。资本和客户都在问同一个问题:做一次到底多少钱,能不能长期这么做下去。这个转向对使用者是好事,它逼着所有人回到常识:做AIGC选型也一样,买东西先看用不用得上,再看贵不贵,而不是先看谁名气大。
名气大的代价,最后都是使用者在付。业务里真正的浪费,往往不是选错了弱的那个,而是给简单的活配了过强的那个,一配就是几个月,账单每个月准时提醒你当初的决定有多草率。
任务分层,才是选型的正经起点
那到底该怎么选?起点不是去对比谁强谁弱,而是先把自己手里的活分清楚。
一个业务里的任务,难度分布从来不是均匀的。大量任务是简单而重复的,规矩清楚、答案有谱,这类活要的是快、稳、便宜;中间一层有点复杂,需要理解上下文,但路数还算固定;真正难的、需要小心推理的,可能只占一小部分。把三层混在一起,统统交给最强的那个去办,是最省心的做法,也是最费钱的做法。
分清楚之后,选择就变简单了:简单的活,给够用且便宜的;难的活,才请出强的。行话里管这个叫分流,说白了就是别拿牛刀杀鸡,也别拿水果刀去砍柴。很多团队把这件事做完之后再看账单,第一反应都是:原来之前一直在为用不上的分数买单。
分层还有个附带的好处:它逼着团队第一次认真看自己的任务长什么样。每个月到底跑了多少次、哪类最多、哪类最容易出错、出错代价有多大,这些数字平时没人统计,一统计全是学问。这也是营销干货里常被低估的一点:选型选到最后,选的其实不是哪个更强,而是你对自己的活到底有多了解。了解越深,钱花得越准;越不了解,越只能跟风买最贵的,图个心安。心安这东西,在账单面前最不值钱,也最靠不住。
贵不贵,要看失败的那一次
光看单价,还会漏掉一笔大账:失败的成本。
便宜的选择如果十次里错三次,人就得在后面跟着收拾三回:重跑要花钱,人工改要花时间,要是错的那一次直接面对了用户,赔进去的是信任。这么一算,便宜可能并不便宜。反过来,贵的选择如果稳稳当当一次过,总账反而低。所以比价格,不能只比标价,要比把一件事办成到底要花多少:调用几次、返工几次、搭进去多少人工。
稳定性也是这么看的。跑量业务最怕的不是慢一点,是飘:今天好好的,明天忽然不行了;高峰时段排队,关键时刻掉链子。业务量小的时候这些都不显,量一大,全是事故。选的时候在高峰时段多压一压、把最难的那批活拿出来多跑几遍,比看发布会上的演示靠谱得多。演示永远挑好的给你看,账单和事故可不会挑。
还有一笔账藏得更深,叫替换成本。今天选的这个,明天想换,难不难?如果所有的用法都和某一家死死绑在一起,换一次就要伤筋动骨,那你就没有议价权了,对方涨价、限流、改规矩,你只能受着。聪明的团队从一开始就留了后手:用法上保持可替换,关键任务备好第二选择。平时看不出区别,等到真出状况或者真要谈价格的时候,这条后路就是钱。
图:AI模型用对地方的关键,是让不同的任务走不同的路。
选之前怎么验货,也有讲究,而且这件事最能看出一个团队是不是在认真算账。别拿网上的评测题去验,那考的是人家的题;拿你自己业务里真实攒下来的任务去验,尤其是平时最容易出错、最难办的那一批。把这批活同时交给几个候选去跑,不看它们答得漂不漂亮,只看三件事:办成一件平均要多少钱、错误都错在什么地方、速度在高峰时段稳不稳。跑完这一轮,差距就不再是榜单上的几分,而是你账本上的几行。很多团队验完会很意外,榜单上排得靠前的,在自己的活上未必占便宜;名不见经传的,反而因为脾气对路、价格实在,成了最后留下的那个。验货验的从来不是谁更强,是谁更合适。合适这个词没法看发布会看出来,只能拿自己的活一把把量出来。量过一次,后面再选就有了自己的尺,而不是每次都借别人的榜单当尺。尺在自己手里,心里就不慌,新东西出来,先拿尺量一量,合不合一目了然,追新的瘾自然就戒了大半。
还有个小习惯,值钱得很:给用量装个闸。业务跑起来之后,调用量是个会自己长大的东西,新功能加一点、用户多一点、某个地方不小心重复调用几遍,月底一看账单,比上个月多出一大截,还找不出是哪儿多的。装闸的意思是,提前给每个月、每个功能定好额度的线,到了线附近就有人来看一眼,超得离谱就先停下来查。不是抠门,是防着无声无息的浪费把利润吃掉。公开报道里这两年不时能看到有团队在短时间内把预算烧穿的消息,听着像段子,落到自己头上就是真金白银。装闸不复杂,难的是从一开始就装。等账单已经烫手了再装,前面烧掉的也要不回来。把闸装上、把分层做好、把验货的尺留着,这三件事加起来,就是一套能长期用的选型规矩。它不性感,也不上新闻,但它能保证你每个月付出去的钱,都花在真正办成的事上。
追新,是最容易上瘾的浪费
再说一个很多团队都有的习惯:追新。新的出来了,赶紧接入;刚接完,又有更新的。团队的精力就耗在这个上面,业务却没往前走一步。
追新上瘾的原因不难理解:怕落后。别人都用上更强的了,我不用,是不是就输了?但业务竞争不按这个算账。用户不会因为你背后的东西更新了一代就多付钱,他们只看自己的事办得怎么样。为了一个用户根本感知不到的提升,去付更高的调用费、去承担新版本的不稳定、去让团队反复折腾迁移,这笔账怎么算都是亏的。
稳妥的做法是给升级定个规矩:不看发布,看问题。现在跑着的,到底卡在哪?是某类任务错误率太高,还是成本已经吃不消,还是速度拖了后腿?有明确的问题,再带着问题去挑新选择,用自己最难的那批任务当场验,验过了再小范围换,换稳了再铺开。没有问题,就让它跑着,把精力留给业务本身。新东西永远会有,问题清单却不会自己变长。按问题升级,团队是主动的;按发布升级,团队是被牵着走的,牵到最后,账上全是为新鲜感付的费。
这话不是说强的东西没价值。真正难的任务,该用强的就用,别省。省钱省在刀刃上,前提是先知道刀刃在哪。把任务分层、把总账算清、把后路留好,强的那个自然会出现在它该出现的地方,而不是被供在所有任务的最前面。
图:AI模型的账,要算到把事情办成的那一刻。
写在最后
回到团队群里那阵热闹。下次再有新发布,先别急着问它到底考了多少分,问三句自己的事:我手里最常见的任务是什么难度?把一件事办成,我现在到底花多少钱?想换的时候,我换得动吗?
还有一句得说给负责人听:选型这件事,最好别变成某个人的信仰。今天偏爱这一家,明天非另一家不用,团队就跟着他的口味反复搬家,搬一次乱一次。把它变成规矩就简单了:每隔一段时间,拿自己最难的那批任务把在用的和市面上新的各验一遍,账算在明处,谁合适用谁,数据说了算。规矩立住了,选型就从站队变成了算账,团队也不用每逢新发布就开一次会、吵一次架。省下来的会,开去聊业务不好吗。说到底,工具是拿来替业务省钱赚钱的,不是拿来供着的;供着供着,业务没供出来,账单先供大了。
这三句答清楚了,选什么其实已经没那么纠结了。AI模型说到底是个干活的,把活分清楚、把账一笔笔算明白、把后路稳稳留好,剩下的交给时间:该升级时果断升级,该省钱时安心省钱。
榜单每个月都会变,名次每个月都有人刷新,账单每个月都要实实在在地付。盯着后者做决定的人,最后一般都不会吃亏,也很少会真正后悔。
本文源自「私域神器」,发布者:siyushenqi.com,转载请注明出处:https://www.siyushenqi.com/73873.html
 微信扫一扫
 支付宝扫一扫