去年12月,一个周二的早上,我是被客服小陈的电话吵醒的——我们那套跑了半年的AI模型客服,一夜之间像换了个人。
"哥,你快看看后台,机器人是不是坏了?"她的声音有点发抖,"今天一早,三个客户说我们敷衍,还有一个说要去别家问问价。"
我睡眼惺忪地打开手机。后台工单里躺着27条新消息,清一色在骂同一件事:自动回复变得又短又冲。有个合作了两年的老客户直接甩了一句原话:"你们这机器人是不是换人了?以前问一句它能回三句,现在倒好,'请自行查看官网'——我花钱是来受气的?"
看到这句话,我后背有点发凉。
我赶到公司的时候,小陈眼睛是红的。她把那27条消息一条条点开给我看,越看我越确定:这不是知识库的问题,也不是提示词的问题——同样的问题,上周回得好好的。老周当时说了句让我印象很深的话:"代码不会一夜之间变渣,人才会。"我们当时都笑了,笑着笑着就笑不出来了:对啊,人才会一夜之间变样,难道……
这套AI客服是我们去年年中上线的,核心就是一个AI模型,接在官网和WhatsApp的客服入口上。提示词是我和技术合伙人老周一个字一个字磨出来的,跑了小半年,投诉率从人工时代的9%降到了2%不到。老板还在会上夸过,说这钱花得值。
代码?我第一反应也是代码。老周被我一个电话薅起来,两个人对着提交记录翻了半小时:最近两周,后端一次提交都没有。提示词模板?没动。温度参数?0.3,从第一天起就没变过。知识库?上周只加了三条退货政策,其余原封不动。
"邪门了。"老周嘟囔,"啥都没动,它凭啥变脸?"
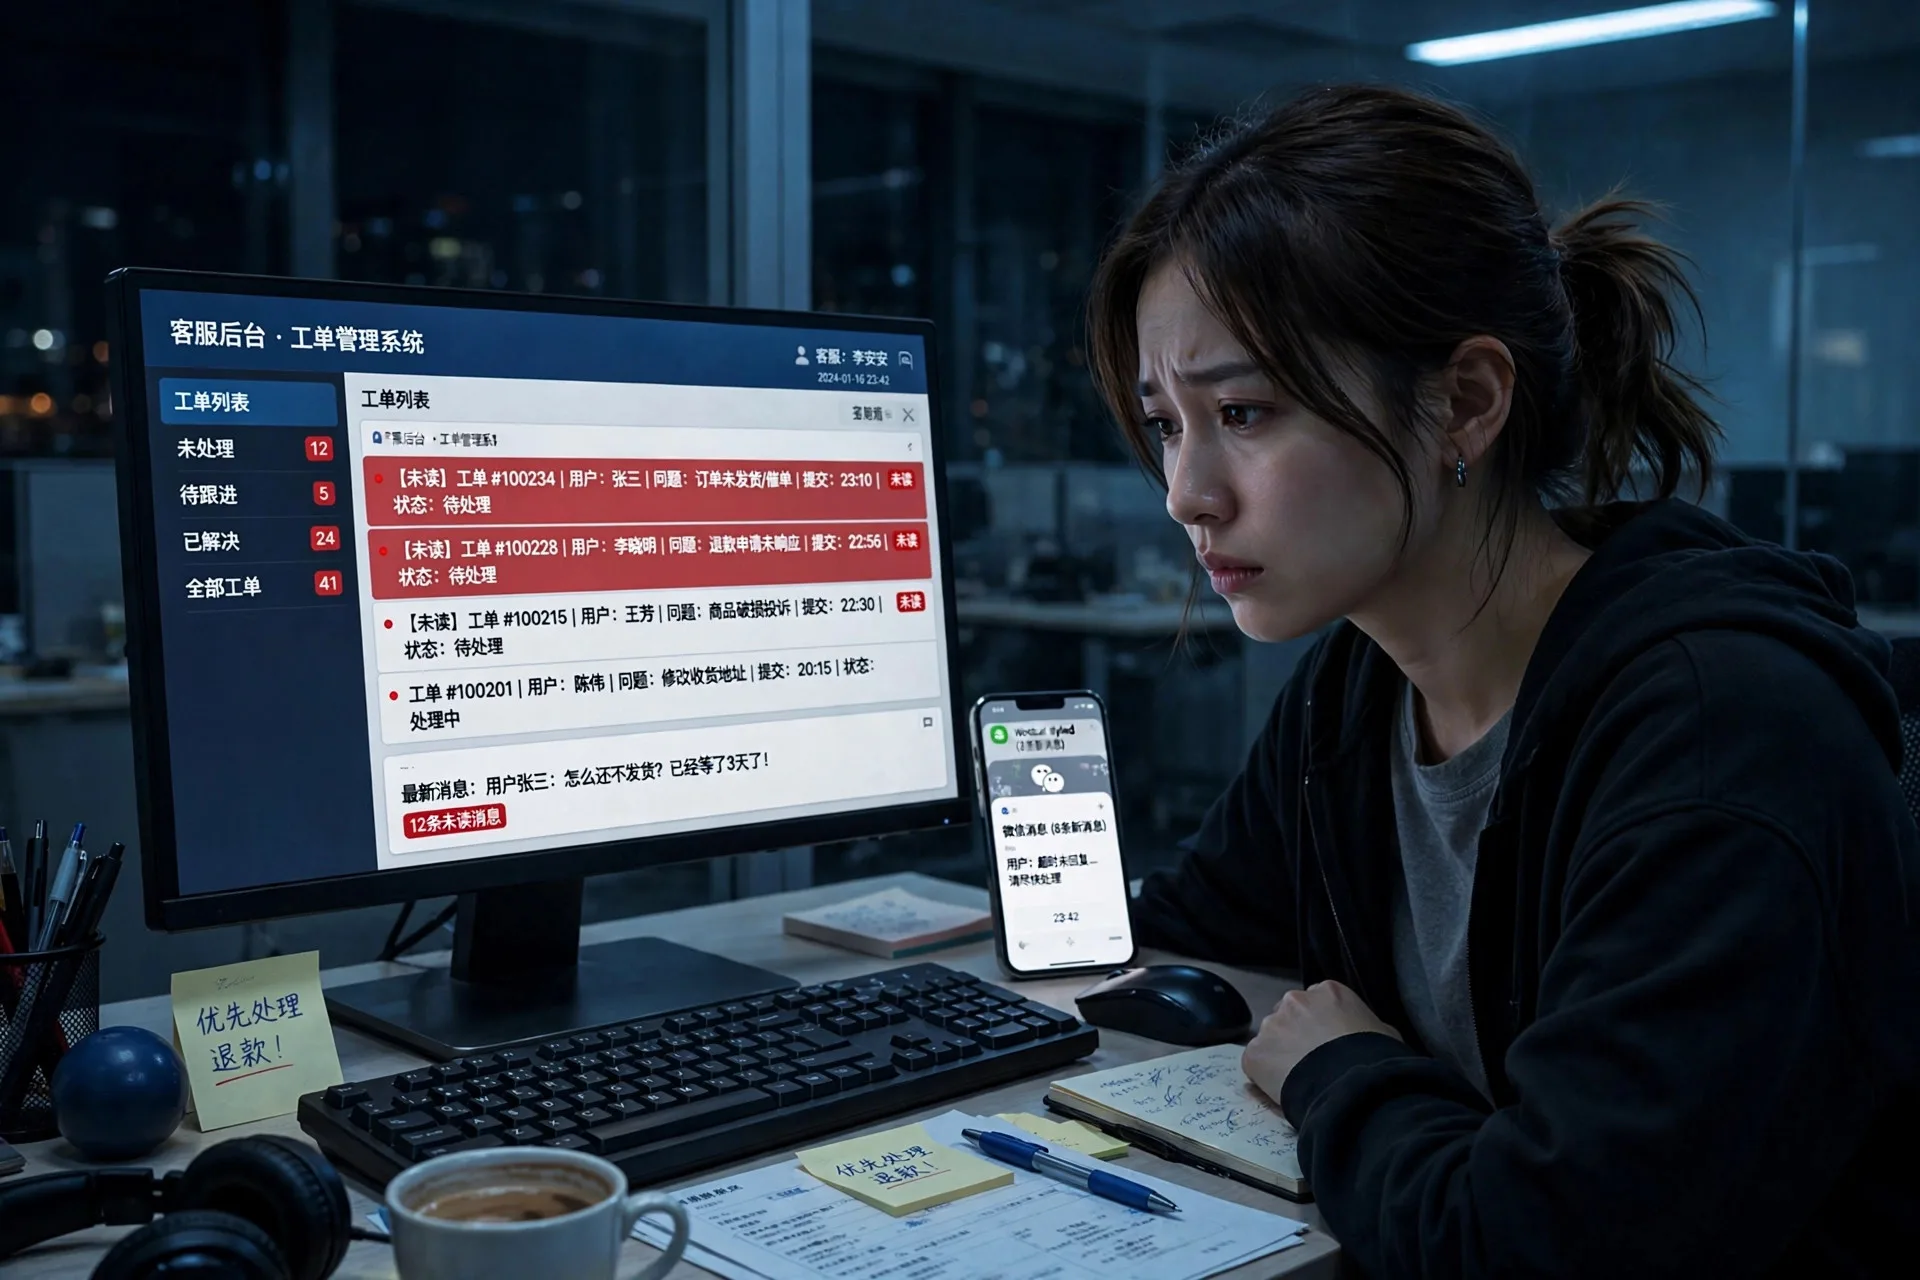
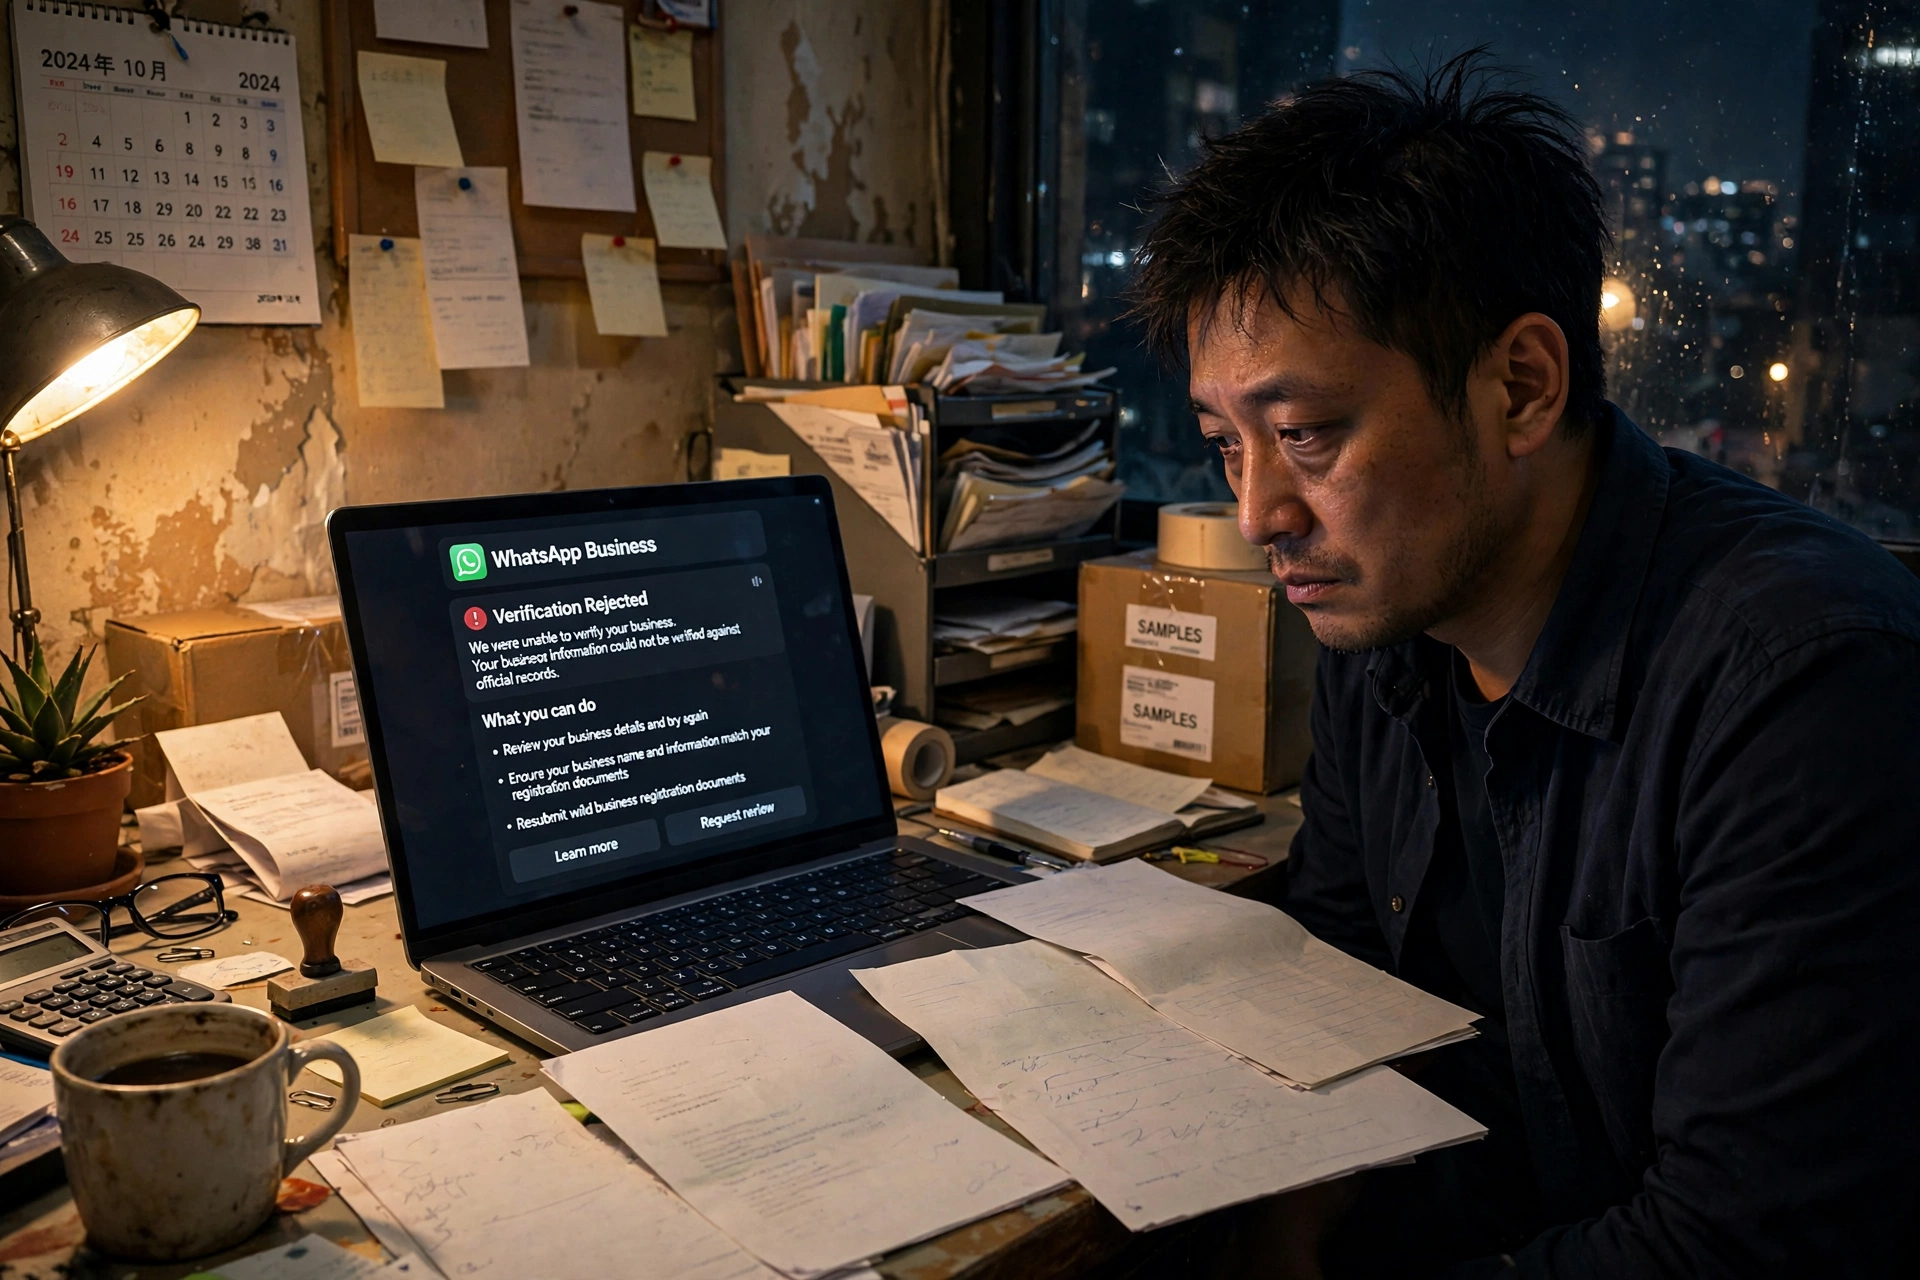
凌晨的办公室,客服后台躺着27条投诉——AI模型静默更新后,自动回复一夜之间变了味
回复从180字缩到60字,找不出原因的两天
我们把出问题的回复全导了出来,一条条看。
以前模型回一条售后咨询,平均180来个字。先安抚两句,再给具体方案,末尾还留一句"还有别的问题随时问我"。出事那两天,平均只剩60字。安抚没了,方案剩半句,结尾那句客套话直接消失。有几条更过分,客户问"发德国的货代时效",它回"请咨询您的货代"——知识库里明明写着汉堡港拼箱12到15天,它看都不看。
最折磨人的是,它不是全错。十条里有七八条是对的,剩下两三条,错得离谱。这种时好时坏,比全挂了还难查。全挂了至少知道从哪下手,时好时坏,你连复现都复现不出来。
为了定位,老周搭了个最笨的对照实验:把出问题的20个问题,原样再问一遍,录下回复;又翻出两周前的聊天记录,把同样的问题找出来对比。结果很有意思:同样的问题,两周前回得滴水不漏,现在十条里有三条开始耍滑头。提示词、参数、知识库全都没变,变量只剩下一个——模型本身。那一刻我们才意识到,一直以为最稳的那个环节,恰恰是最会变的。
"这不像程序出 bug,"老周盯着屏幕看了半天,憋出一句,"bug 一般是全挂。它这是……时好时坏,像换了个人格。"
人格。这两个字点醒了我。
同一个AI模型,人格是会变的吗?在此之前,我从来没想过这个问题。在我心里,模型跟数据库差不多:你存进去什么,它就吐出来什么,稳得很。现在看,天真了。
锅找到了:AI模型版本号,悄悄换了
我们调用模型时,图省事,用的是厂商给的"最新版"别名。心想这样多好,厂商一升级,我们自动吃到更强的能力,不用半夜爬起来改配置。
老周去翻调用日志,对上版本号的那一刻,两个人都沉默了。
上游在12月9号那一周,把这个别名指向了一个新版本。我们一行代码没改,用的已经不是原来那个模型了。它"变懒"了——回复变短、变敷衍、多一事不如少一事,正好就是新版本的"性格"。
为了确认,老周又做了一件事:找厂商要了上一个版本的快照,把那20个问题重跑了一遍。回复长度回来了,180字,语气也回来了。实锤了:不是我们的问题,是AI模型换了。那一刻我心情挺复杂的——松了口气的是终于找到原因,憋屈的是,这个原因我们完全控制不了。
这事,真不是我们倒霉。2024年1月,OpenAI 官方发过一次模型更新公告,亲口承认新版本要"减少模型变懒、不完成任务的情况"(来源:OpenAI 官方开发者公告,2024年1月25日,经 Cointelegraph 等多家媒体报道)。背景是2023年12月,大批用户在社交媒体上吐槽 ChatGPT 突然变懒:拒绝干活、把活甩回给用户、写代码写一半撂挑子。连 OpenAI 自己,都得专门发新版来"治懒"。(选模型踩过的第一个坑,榜单和账单那笔账,写在AI模型选型复盘里了。)
你看,模型的行为,真不是刻在石头上的。今天它耐心,明天它就可能敷衍,全看上游那次更新改了什么。而我们这些调用方,经常是最后一个知道的。
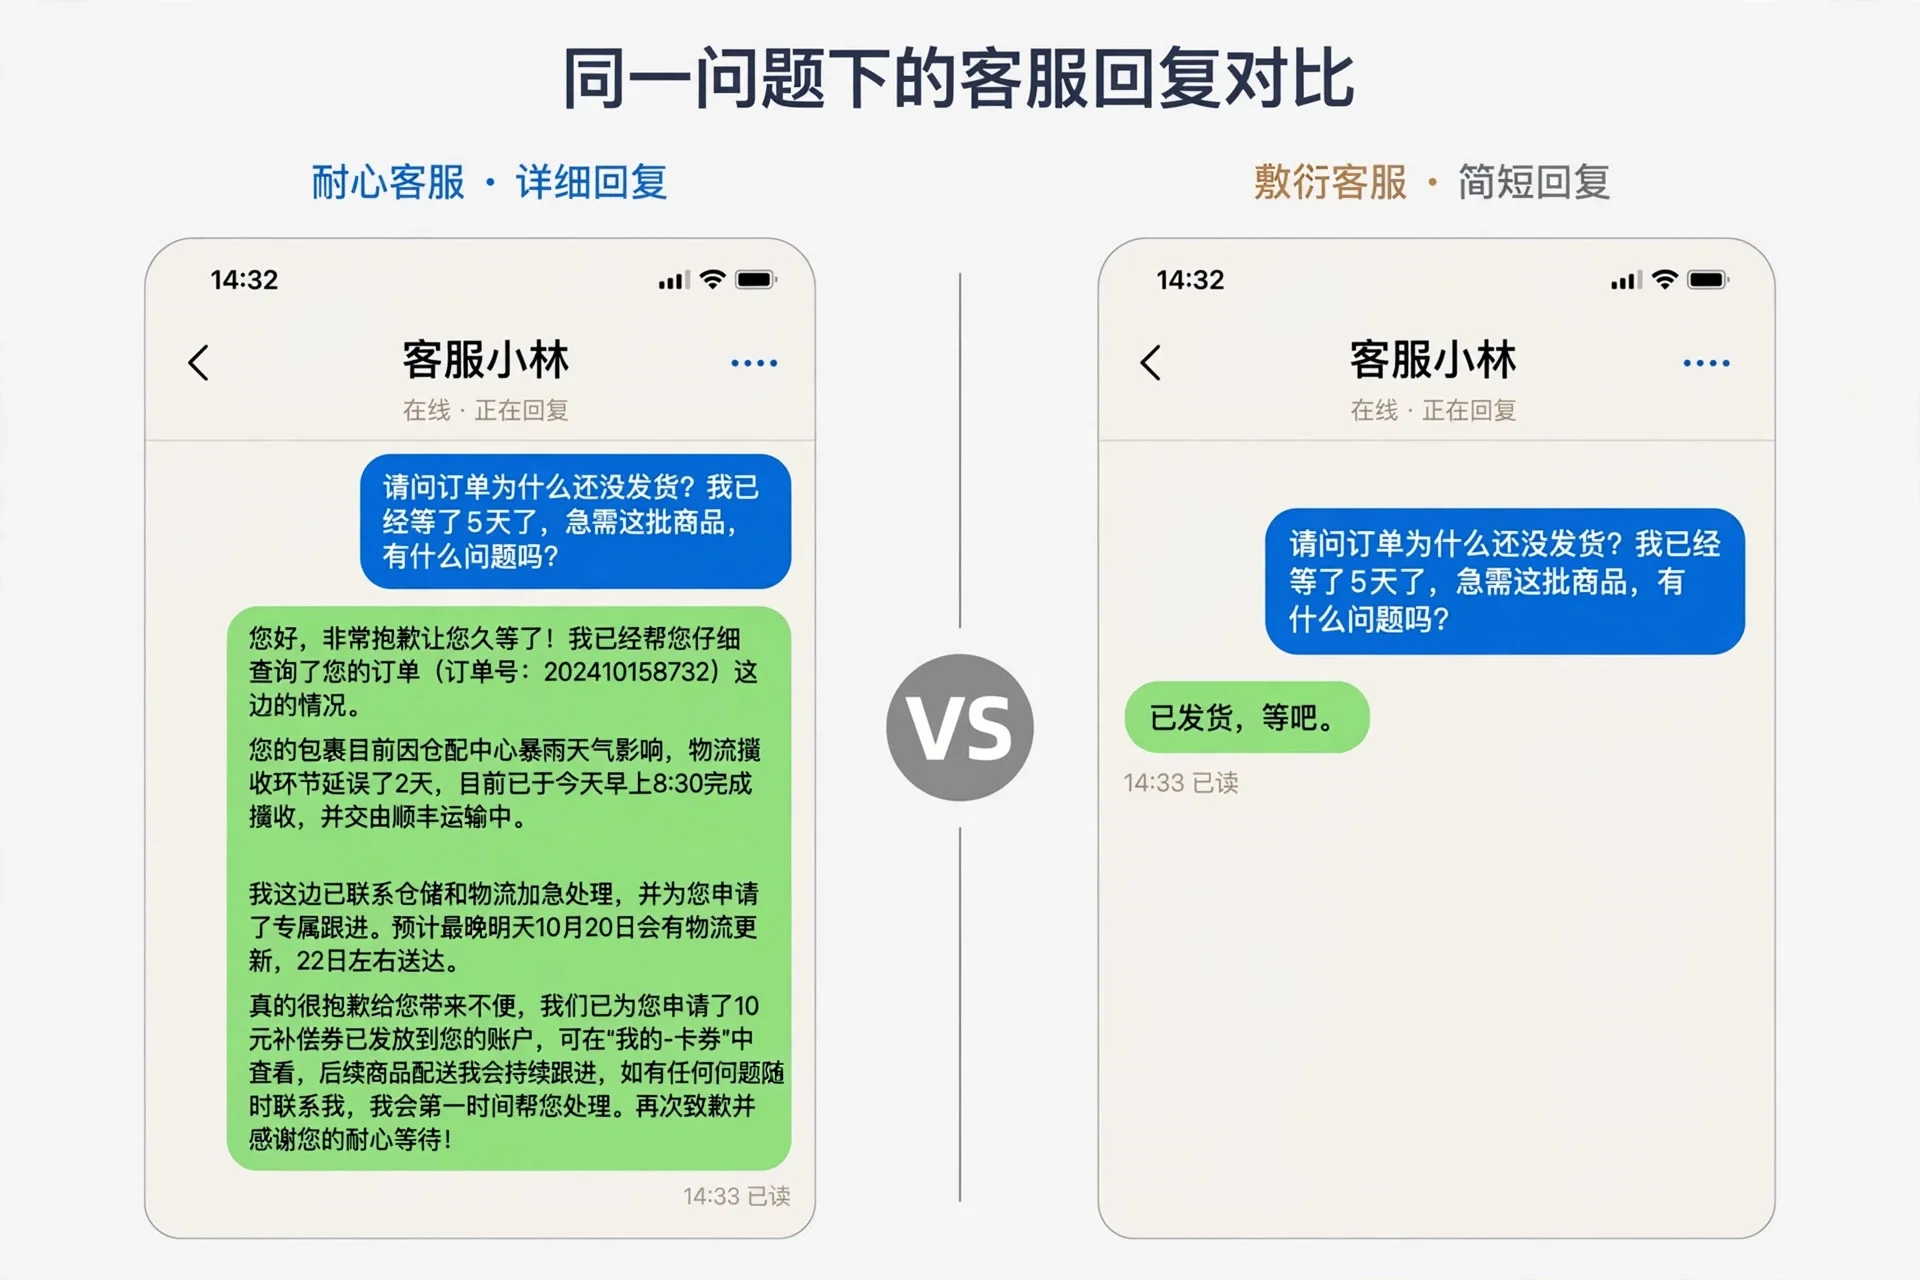
同一AI模型新旧版本回复对比:左边180字的耐心解答,右边60字的敷衍了事,客户一眼就能看出差别
生产环境的三条土规矩,是拿投诉换来的
那次之后,我们定了三条规矩,土,但管用。
第一,版本号写死,再也不用"最新版"别名。调用时 pin 到具体版本,比如 gpt-4-0613 这种。新版本出来了?可以,先在测试环境跑两周,没问题再切。听起来很笨是吧?但生产环境要的从来不是"最新",是"可预期"。你今天省下的那点升级麻烦,早晚会以投诉的形式,连本带利还回来。
我们还专门建了个版本台账:每个版本的上线日期、灰度数据、回滚记录,全记下来。半年后回头看,哪次更新最折腾,一目了然。
第二,攒一套回归测试题,每周跑一遍。我们从历史工单里挑了80个典型问题:售后、报价、交期、投诉,各种刁钻问法都有。每次模型版本有任何风吹草动,先跑这80道题,回复长度、关键信息点、语气,逐项对。分数掉了,立刻报警。这套题现在是我们的"体检表",比监控报警还灵。
这80道题也不是随便凑的:30道售后、20道报价交期、15道投诉安抚、15道刁钻问法(比如客户连发三条语音转文字、前后矛盾的需求)。每道题我们都写了"标准答案要点":德国货代那题,必须出现"汉堡港""12到15天"才算过;投诉安抚那题,开头必须有安抚话术,少一句都不行。跑分低于95分,版本切换流程直接锁死,谁来说情都没用。
第三,灰度切换,留好回滚的门。真要换版本,先切10%的流量过去,盯三天投诉率和解决率。数据没问题,再全量。回滚方案提前写好,写到一行命令就能执行的那种。别等出事了再翻文档找开关——出事的时候,你的手是抖的。
灰度期间我们盯三个数:投诉率、一次解决率、平均回复长度。任何一个掉超过10%,立刻回滚,不用开会讨论。回滚命令就一行,值班的人闭着眼睛都能敲出来。真出事的时候,你没时间翻文档,也没时间走审批。
现在我们每个月还会做一次"模型体检":回归题全量跑一遍,顺带看一眼厂商的更新日志。上个月日志里写"优化了长回复的简洁性",我们当场就把灰度流程走了一遍——"简洁性"这种词,翻译过来很可能就是"变短"。果不其然,灰度数据里平均回复长度掉了12%,我们直接没切。有时候,更新日志比评测榜单诚实多了。
这三条,没有一条是高科技,全是土办法。但自从立起来,我们再也没被模型的"性格变化"打过措手不及。
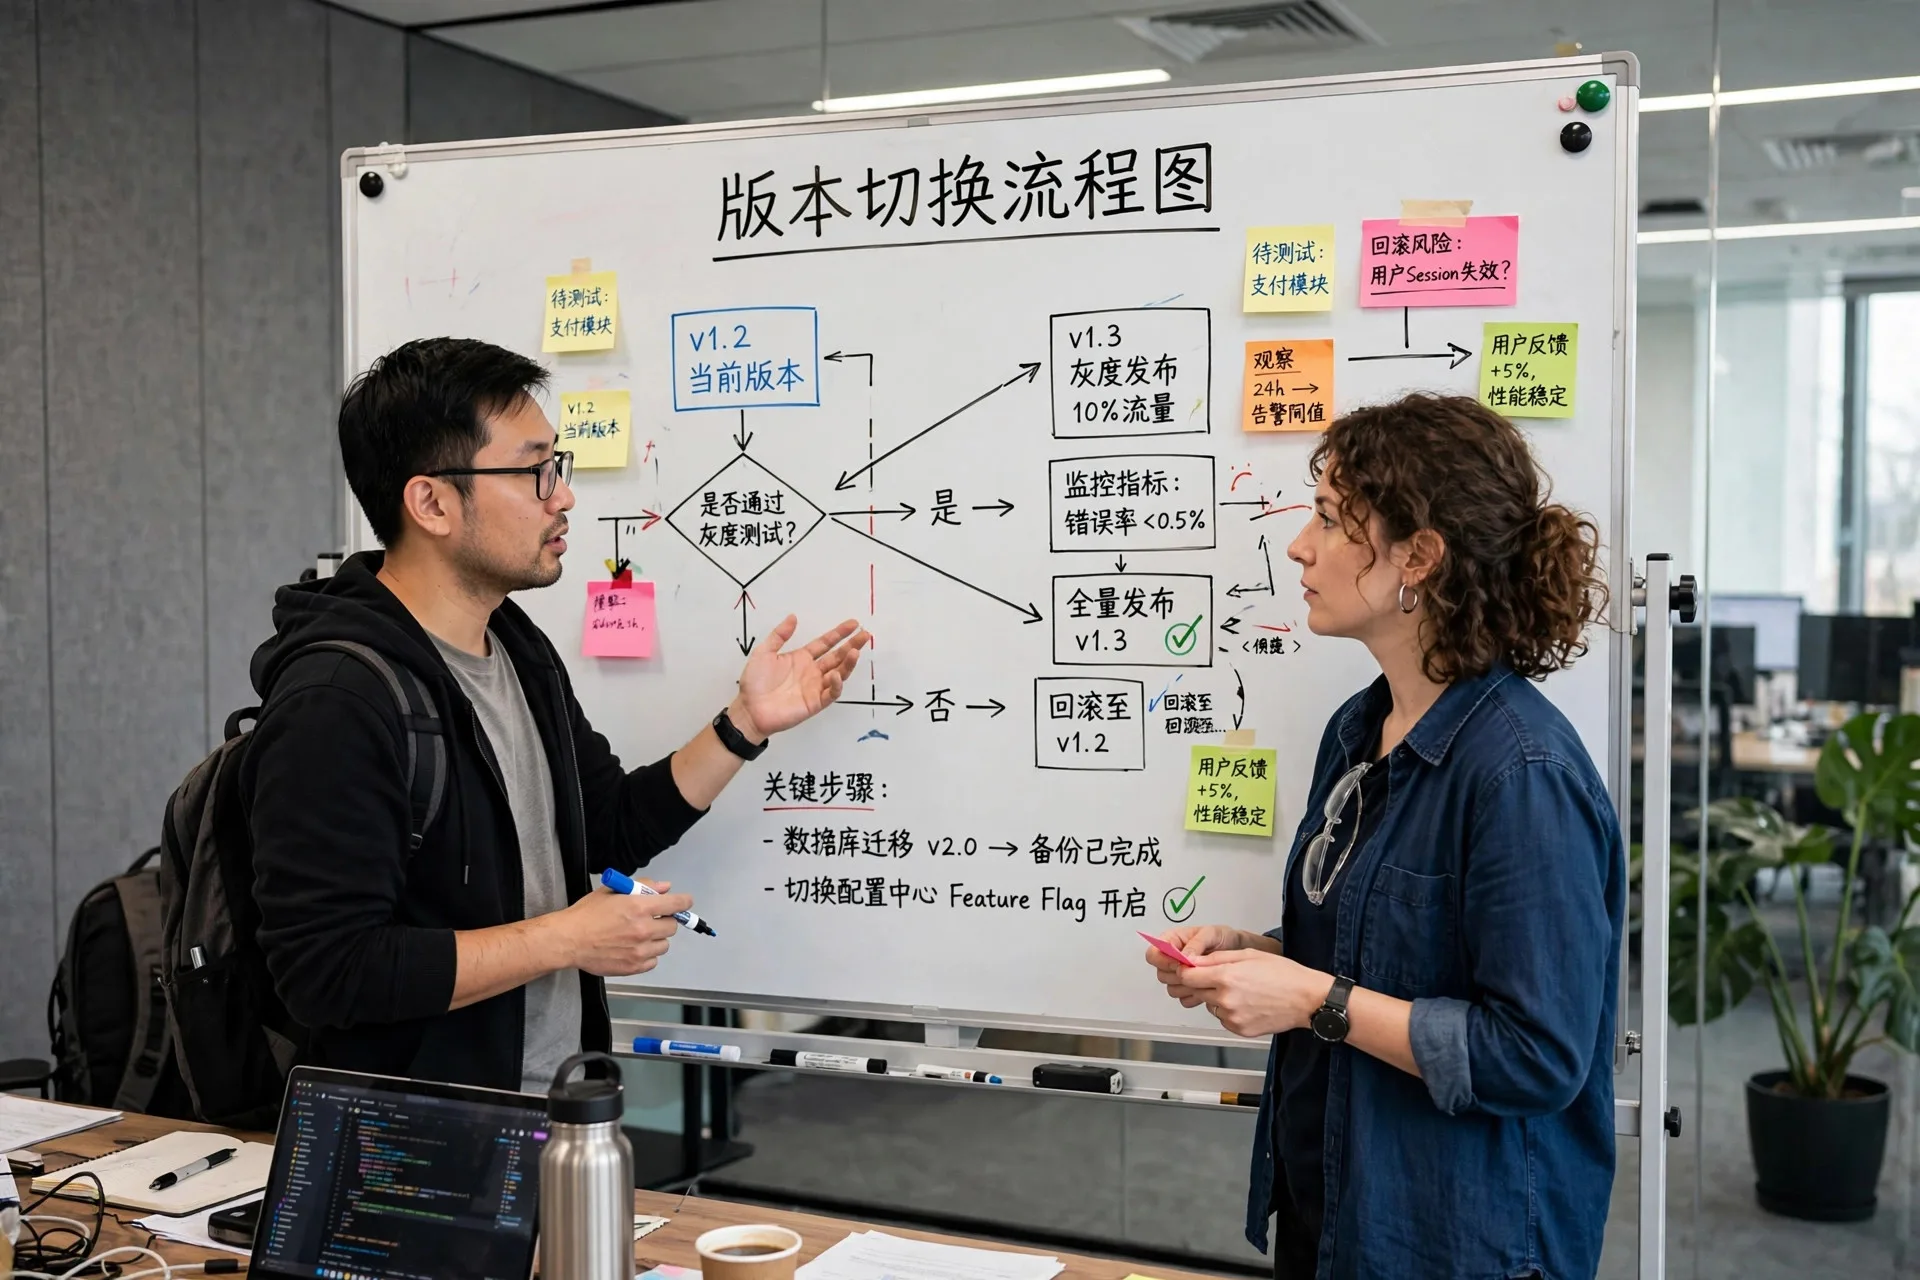
AI模型版本灰度切换流程:先切10%流量盯三天,数据没问题再全量,回滚开关提前备好
榜单第一,救不了生产
有件事我越想越觉得有意思。
Menlo Ventures 2025年12月发布的报告里有个数字:2025年企业在生成式AI上的支出达到370亿美元,一年翻了三倍多(来源:Menlo Ventures《2025 State of Generative AI in the Enterprise》)。钱越堆越多,说明大家是真信这东西能干活。
但我敢打赌,一大半团队跟当时的我们一样:模型版本裸奔,更新全靠厂商自觉。今天榜单第一的模型,你敢直接拿它的"最新版"别名去跑生产吗?榜单测的是能力上限,生产环境要的是稳定性下限,这是两码事。
现在我们选模型,先看三样东西:厂商给不给锁版本(有没有类似 gpt-4-0613 这种快照);版本下线提前多久通知(至少留三个月缓冲才敢用);有没有公开的变更日志。上次评估一个厂商,文档里写"我们会不定期优化模型行为",看到这句我们直接 pass——"不定期优化"翻译过来就是"随时可能变脸,还不告诉你"。能力分再高,这种也不敢往生产里放。
说白了,选模型跟招人一个道理。简历漂亮(榜单分高)的人,不一定坐得住(行为稳定)。生产环境要的是能长期共事的老员工,不是每个月换一次性格的天才。
能力强,不等于靠谱。靠谱的意思是:它今天什么样,明天还什么样;你让它干A,它不会悄悄去干B。这个"不变",恰恰是现在这些天天更新的AI模型最缺的东西。
所以我的结论可能有点反常识:选模型,版本管理策略比模型本身更重要。一个能力85分、但版本锁定、行为可预期的模型,在生产环境里,吊打一个能力95分、但每个月悄悄换人格的模型。前者让你睡得着觉,后者让你半夜被客服电话吵醒——我亲身试过,真的。
小陈后来跟我说,那27条投诉里,有个客户最后留了一句:"机器人可以笨,但不能翻脸。"我觉得这话说到点子上了。客户不怕你慢,怕的是你今天一个样明天一个样。做AI客服这行,稳定压倒一切,稳定,就是最大的能力。
这件事之后,我们跟模型厂商的对接方式也变了。商务合同里加了一条:版本变更提前30天书面通知,否则我们有权按原版本快照继续调用三个月。销售一开始说没这个先例,我说那27条投诉就是先例。后来他们还真给了——原来这条款一直有,只是没人问,就没人提。
(更多实战复盘,见营销干货分类。)
本文源自「私域神器」,发布者:siyushenqi.com,转载请注明出处:https://www.siyushenqi.com/74533.html
 微信扫一扫
 支付宝扫一扫